
作者:AI世界
MiniMax H3 的 Ref2V(Reference-to-Video,参考图驱动视频)Turbo 加速 LoRA 权重。- 任务:Ref2V / R2V,多参考图/视频/音频驱动视频生成- 采样步数:8 步(相比基准 ~20 步大幅加速)- 分辨率:768p(1344×768, 16:9)以内- 框架:ComfyUI 原生支持,权重已转换,无需额外转换- 精度:BF16- 格式:safetensors
版本:1.0
比0.1版本 视频细节和音频质量都明显更好。
使用方法:将文件放入 ComfyUI/models/loras/在 Ref2V 工作流中,于模型加载器与采样器之间挂载此 LoRA,连接一张或多张参考图到 reference-input 分支,运行 8 步采样。建议配合使用的基座权重:- diffusion_models/: minimax_h3_ref2va_pruned_int8_convrot.safetensors- text_encoders/: qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors- vae/: minimax_h3_video_vae_fp16.safetensors + minimax_h3_audio_vae_fp32.safetensors
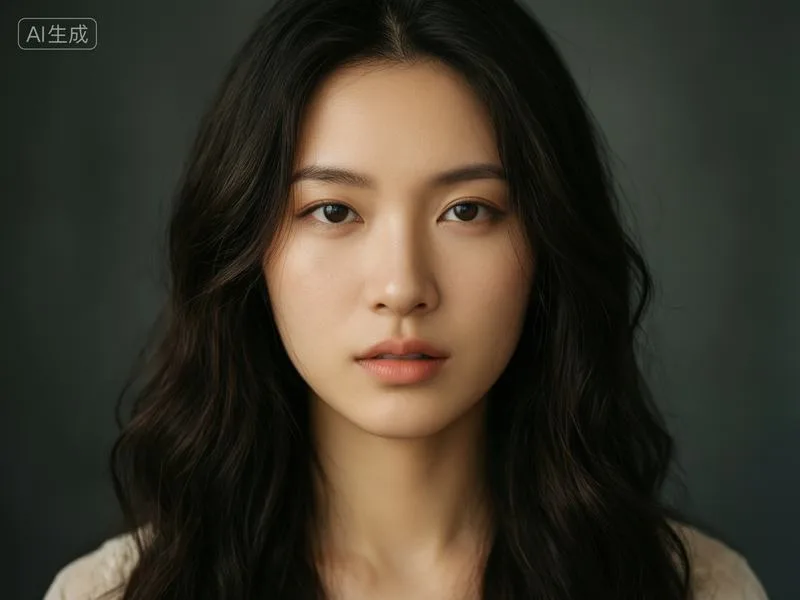
模型预览图(来自模型页图库):
下载地址:
直接下载链接(签名直链,可能有时效;失效时请用下方模型页)
模型页面(登录后下载): https://www.liblib.art/modelinfo/64ef3233386d41f689fdd60025d7323b
社区评论(共 1 条,前 1 条):
- 星球的AI畅想:改一下呢 这怎么是大模型呢?(2026-09-13)
0 条评论